个人项目 / 文档 RAG
作品集文档 RAG
这个助手曾根据我的文档回答关于作品集的问题,使用 VPS 上的 ChromaDB 检索内容,并通过外部 API 调用模型。
用户问题
作品集中哪些项目使用了向量检索?
上下文检索
基于上下文的回答
文档 RAG 项目使用向量检索,在生成回答前查找相关段落 [1][2]。
- [1] RAG 项目
- [2] 文档库
从用户问题到带来源的上下文回答的简要流程。
背景
我曾将这个助手集成到旧版作品集中,让访客可以直接询问我的项目和 Markdown 笔记内容,无需逐页浏览。
用 Ollama 做过本地测试后,我把检索留在 VPS 上,将生成交给外部 API。
运行方式与架构
系统分为两个阶段:先准备文档,再针对每个问题检索相关段落。
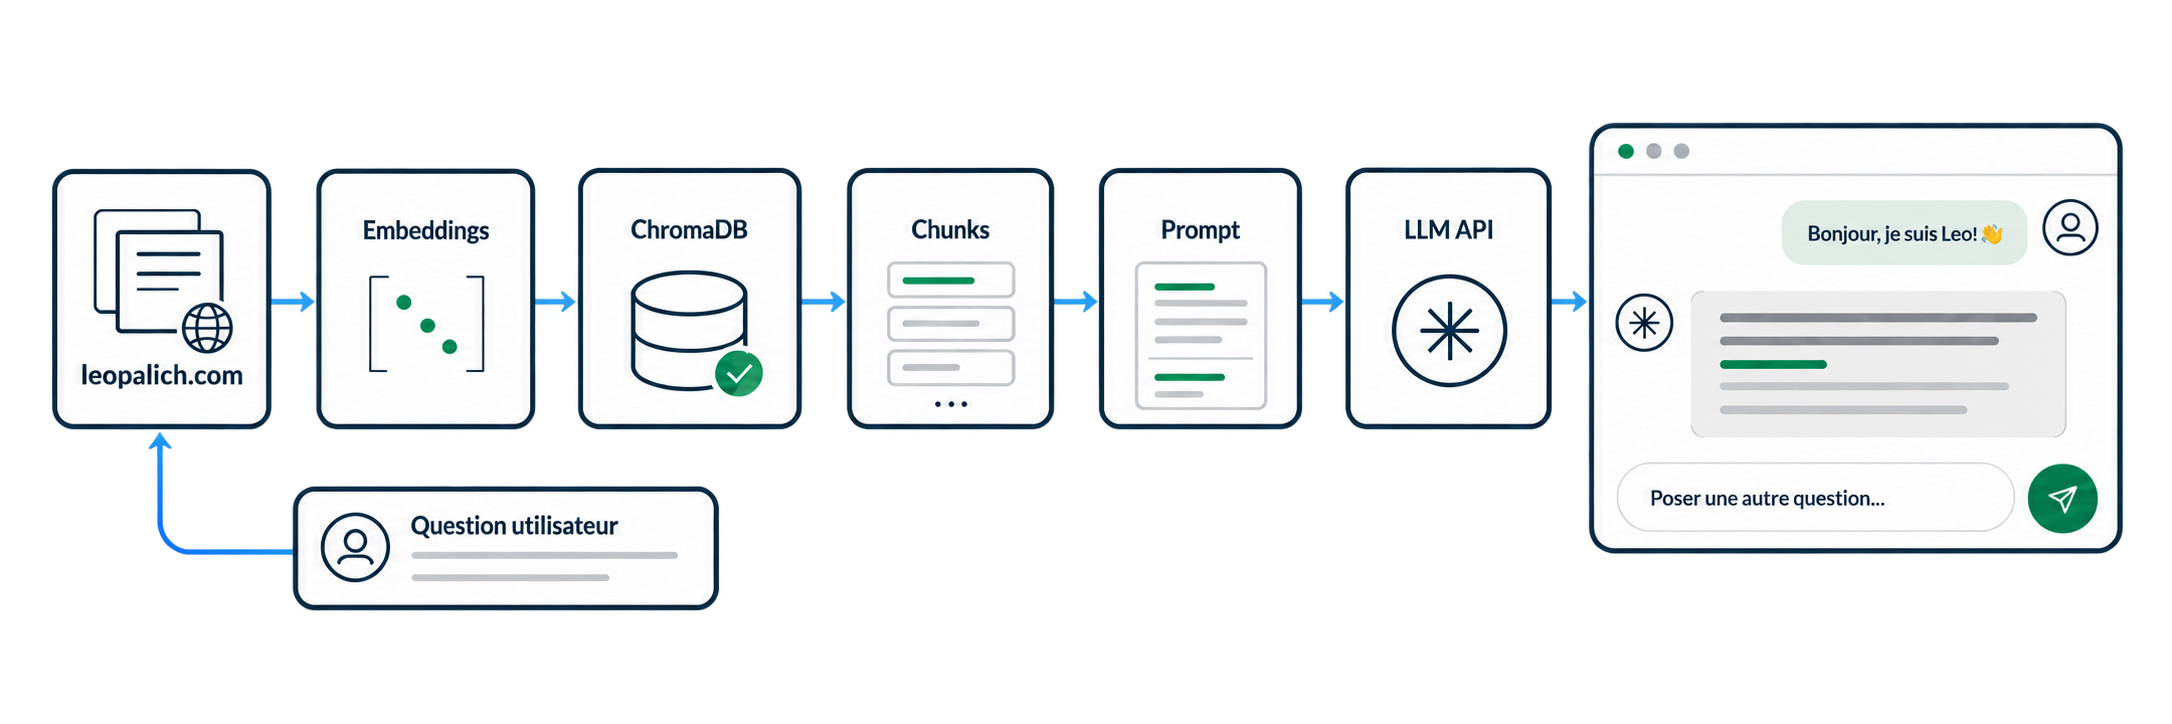
旧版作品集 RAG 助手的流程。
在 VPS 上检索,再通过外部 API 生成回答。
索引
Markdown 文件被切分为段落,转换为 embeddings 后存入 ChromaDB 建立索引。这一步在处理查询之前完成。
ChromaDB 通过 Docker 运行在 Linux VPS 上。
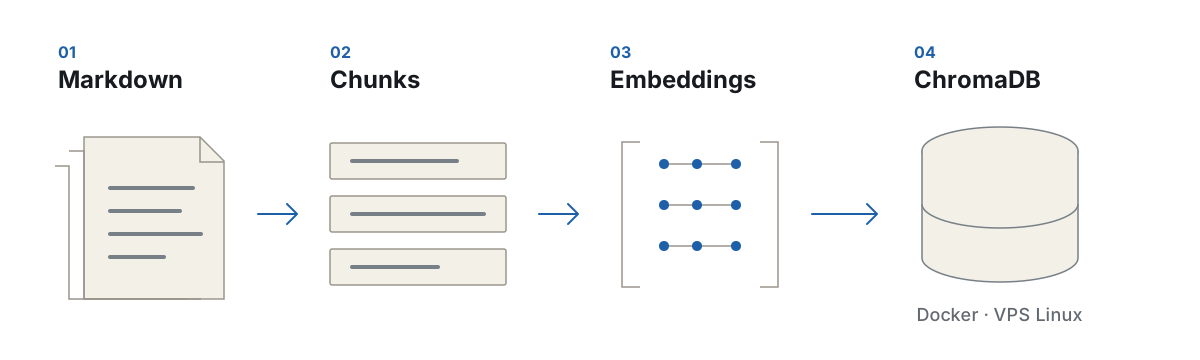
查询前的 Markdown 语料准备:文本段、embeddings 与 ChromaDB 存储。
查询
Node.js 接收问题,从 ChromaDB 检索相关段落,将上下文组装进 prompt,再通过外部 API 调用模型。生成的回答随后在 Astro 界面中逐步显示。
组件
- 界面
- Astro
- 语料
- Markdown
- 编排
- Node.js
- 检索
- ChromaDB
- 生成
- 通过外部 API 调用模型
- 基础设施
- 用于 ChromaDB 的 Docker / Linux VPS
局限
这个原型目前没有可供参考的质量、延迟或覆盖率量化数据。
可进一步评估的方向
- 语料的时效性与可追溯性;
- 使用代表性问题评估检索效果;
- 非公开文档的访问权限管理;
- 来源展示与不确定性的明确处理。